4090 视频超分 · 文字保真
实测汇总(第二版)
一、测试口径
这一节是后面所有表的共同口径,每张表都能单独读。
1.1 命名与版本对照("numz" 是社区实现的仓库名,不是版本号)
| 报告里的名字 | 是什么 | 实现与本项目改动 | 单条耗时 | 94 条已评 |
|---|---|---|---|---|
| 官方 3B / 7B | SeedVR2 原仓库的推理,经 E1 wrapper 调用 | 原仓库;45 帧一段、重叠 1 帧;输出 h264 ≈18 Mbps | 705.5 / 823.8 s | 是 |
| E1 无损 / E1 colorfix | 官方 3B 输出的无损复现路径(colorfix 多一步色彩校正) | 我们的 wrapper;94/94 条 mp4 与官方 3B 逐字节相同 | 192.6 / 192.2 s | 是(3B) |
| numz 3B · wave = 默认方案,下面简称 numz_wavelet | 社区 ComfyUI 实现 github.com/numz/ComfyUI-SeedVR2_VideoUpscaler(NumZ 团队 + AInVFX 维护,基于 ByteDance SeedVR2)+ 本项目加速第 1–3 步 | batch 121 整段窗口 / overlap 4、DiT+VAE fp16 并 offload 到 CPU、DiT+VAE cache、模型常驻;--color_correction wavelet;输出 mpeg4 ≈35 Mbps | 159.1 s | 是 |
| numz 3B · lab = 备选,下面简称 numz_lab | 同上,--color_correction lab | 同上,只换色彩校正 | 158.2 s | 是 |
| numz 3B · wave + 全加速 = 第七节的 101.4 s 配置 | 在 numz_wavelet 之上再加加速第 4、5 步 | layout/copy 优化、GN 融合、warm cache;输出逐位一致(torch.equal + mp4 md5) | 101.4 s | 否(只跑了 1 条) |
两者不是一回事:"numz" = 社区实现(带来整段窗口、fp16+offload、cache 等工程特性,159 s vs 官方 705 s);"默认方案" = 这套社区实现 + wavelet 色彩校正 = numz_wavelet。官方 3B/7B 是另一条线,与它不是 bit-exact 关系(实现、窗口、编码、色彩校正四项都不同),这四项的贡献尚未逐项归因。
1.2 加速改动清单:加了什么、在报告哪张表里
| 步骤 | 改了什么 | 单条耗时 | 输出是否逐位一致 | 在报告里的位置 |
|---|---|---|---|---|
| ① 官方基线 | SeedVR2 原仓库,45 帧分段 | 705.5 s | — | 主表「官方 3B」行 |
| ② E1 无损封装 | 统一 dtype / 去掉多余拷贝 / 帧对齐 | 192.6 s | 是(94/94 条逐帧一致) | 主表「E1 无损」行 |
| ③ numz 管线(b121 + fp16 + cache + 常驻 + wavelet 校正) | 社区实现 + 本项目第 1–3 步加速 | 159.1 s | 否(与官方实现不同) | 主表「numz …(wavelet)」行 ← 默认方案 |
| ④ layout / copy 优化 | 减少张量搬运与内存重排 | 112.1 s | 否(未逐条验证) | 第七节瀑布图 |
| ⑤ GN 融合 + warm cache | 归一化统计融合、缓存复用 | 101.4 s | 是(torch.equal=True,mp4 md5 一致) | 第七节瀑布图;散点里的「numz 加速」外推点(¥0.028/秒) |
为什么主表里只有第 ③ 步:第 ④、⑤ 步只改耗时、不改输出,但 94 条还没重跑,所以主表与分语种表用的都是第 ③ 步(159.1 s)的结果;散点图里那个 ¥0.028/秒 的「numz 加速」点是用 101.4 s × 单条外推的,不是实测。补完 94 条 A/B 之后,两者的数字会统一。
1.3 素材
| 素材 | 来源 | 规格 | 样本量 | 用途 |
|---|---|---|---|---|
| CTVid-Bench temporal | ClearText-Video(arXiv 2608.28784) | 480×270 → 1080p,4 s / 120 帧 / 30fps,逐帧文字标注 | 94 条(中文 29 / 拉丁 48 / 混排 17) | 主表、分语种、案例墙 |
| H3 原生 480p 英文片 | MiniMax-H3 生成(vtr_bench/minimax-h3_low_short,Apache-2.0) | 832×480 → 1872×1080(×2.25),121 帧 / 24fps | 40 条 | H3 矩阵 N480 |
| H3 原生 768p 英文片 | MiniMax-H3 生成(vtr_bench/minimax-h3_high_short) | 1344×768 → 1890×1080(×1.406),121 帧 / 24fps | 40 条 | H3 矩阵 N768 |
| H3 768p 降采样片(有像素 GT) | 同上 + H3 自生成中文集(H3-Self-Generated) | GT 1344×768;LR = 降采样 832×480 + H.264 crf23;回超到 1344×768,124 帧 | 40 条(中 24 / 日 4 / 英 12) | H3 矩阵 S768(唯一有像素 GT) |
口径:CTVid 用官方逐帧标注做文字 GT;H3 没有逐帧标注,用 prompt 原文当标签(见 5.1)。两边的 GT 构造方式不同,数字不能跨素材直接比。
1.4 评测协议
| 层 | 指标 | 口径 |
|---|---|---|
| 全参考画质 | PSNR(RGB) / SSIM(Y, gaussian) / LPIPS(alex) / DISTS | 输出与 GT 原片逐帧比;CTVid 评测域 = GT 第 28–1052 行 × 第 0–116 帧,每 8 帧取一帧;S768 = 1344×768 全帧,每 8 帧 |
| 文本保真 | Acc / NED / CER / Det F1 / 漏读率 / 高置信错读率 / 严重错读率 / 翻转率 | PaddleOCR 3.3 + PP-OCRv5(CPU),每 4 帧采样;Acc = 归一化后完全相等;NED = 1 − 归一化编辑距离;CER = 字符错误率;翻转率 = 同一框相邻采样帧读数不同 |
| 内容改写 | LPIPS / DISTS(输出 vs 原生输入) | 不是画质分,是"模型把画面改了多少"的代理:纯插值回环应接近 0,生成式模型会凭空造像素 |
| 效率 | 单条墙钟 / 单条成本 / 峰值显存 | 单卡 4090;成本 = 墙钟 × ¥4/卡时;同时给均值与 p10(p10 近似无争用耗时) |
没有做的层:FVD(需要 ≥2048 段视频,40 条不成立)、VBench 16 维(针对生成模型本身,不针对超分)、无参考画质(NIQE / MUSIQ / CLIPIQA,本机未装 pyiqa)、VLM 下游问答(week1 跑过 Qwen2.5-VL-3B,本轮未复跑)。
1.5 噪声底与 GT 上限
| 项 | 数值 | 来源 |
|---|---|---|
| GT 原片自身的 Acc(94 条) | 0.832 [0.766, 0.891] | OCR 在 1080p 原片上的上限,不是 1.0;分语种 中文 0.885 / 拉丁 0.831 / 混排 0.747 |
| 编码噪声底 | ΔAcc −0.015 [−0.030, −0.001] | 同一 bicubic 只换编码(yuv420p → 无损),像素几乎无差 |
| 判定规则 | |ΔAcc| < 0.02 不作结论 | 本文所有 ▲/▼ 都按 95% bootstrap 区间是否跨 0 判定 |
| 置信区间 | 按视频 bootstrap(主表 2000 次,配对差值 10000 次) | 先按视频求差再重抽样 |
| 火星文率 | GT 自身 0.029 | 高置信(≥0.8)却读错(NED<0.5)的实例比例;GT 这一项主要来自标注/OCR 噪声 |
二、总体结果:94 条全量主表
14 个方法 × 11 个指标,94 条 CTVid。区间是按视频 bootstrap 的 95% CI。数值越小越好的指标已在表头标 ↑/↓。
| 方法 | Acc ↑ | NED ↑ | 翻转率 ↓ | Acc_rd ↑ | 火星文率 ↓ | PSNR ↑ | SSIM ↑ | LPIPS ↓ | DISTS ↓ | 耗时 s 均值 / p10 |
成本 ¥ 均值 / p10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| GT 原片(上限) | 0.832 | 0.958 | 0.109 | — | — | — | — | — | — | — | — |
| numz 3B(lab) | 0.794 | 0.944 | 0.153 | 0.819 | 0.25% | 29.26 | 0.890 | 0.109 | 0.060 | 158.2 / 152.4 | 0.176 / 0.169 |
| 官方 7B | 0.792 | 0.945 | 0.159 | 0.817 | 0.17% | 28.28 | 0.883 | 0.126 | 0.062 | 823.8 / 755.0 | 0.915 / 0.839 |
| ★ numz 3B(wavelet) | 0.791 | 0.945 | 0.161 | 0.816 | 0.36% | 29.31 | 0.889 | 0.107 | 0.058 | 159.1 / 151.1 | 0.177 / 0.168 |
| E1 colorfix | 0.753 | 0.935 | 0.200 | 0.777 | 0.52% | 26.98 | 0.856 | 0.135 | 0.066 | 192.2 / 182.3 | 0.214 / 0.203 |
| 官方 3B | 0.747 | 0.934 | 0.201 | 0.770 | 0.41% | 27.49 | 0.865 | 0.136 | 0.066 | 705.5 / 699.0 | 0.784 / 0.777 |
| E1 无损(= 官方 3B 逐位) | 0.747 | 0.934 | 0.201 | 0.770 | 0.41% | 27.49 | 0.865 | 0.136 | 0.066 | 192.6 / 180.0 | 0.214 / 0.200 |
| bicubic(无损) | 0.669 | 0.908 | 0.324 | 0.691 | 0.67% | 27.87 | 0.866 | 0.281 | 0.152 | CPU | ≈0 |
| MediaKit(云端) | 0.656 | 0.898 | 0.332 | 0.677 | 0.61% | 27.48 | 0.868 | 0.192 | 0.118 | 云端 ≈150 s | 0.10* |
| FastVR | 0.604 | 0.887 | 0.380 | 0.624 | 0.22% | 26.18 | 0.823 | 0.183 | 0.100 | 40.4 / 33.2 | 0.045 / 0.037 |
| FlashVSR+ Turbo | 0.581 | 0.871 | 0.398 | 0.599 | 0.34% | 26.11 | 0.822 | 0.160 | 0.086 | 37.6 / 31.3 | 0.042 / 0.035 |
| FlashVSR+ Base | 0.560 | 0.863 | 0.427 | 0.578 | 0.38% | 24.85 | 0.801 | 0.171 | 0.093 | 49.2 / 43.1 | 0.055 / 0.048 |
| FlashVSR | 0.549 | 0.853 | 0.442 | 0.562 | 0.56% | 25.15 | 0.791 | 0.179 | 0.094 | 20.0 / 19.1 | 0.022 / 0.021 |
| ReCaVSR | 0.524 | 0.842 | 0.431 | 0.542 | 0.59% | 26.59 | 0.830 | 0.150 | 0.078 | 58.3 / 44.7 | 0.065 / 0.050 |
列定义:Acc_rd = 只统计 GT 原片能读出的实例;火星文率 = 高置信却读错的实例比例(GT 可读子集);翻转率 = 同一 GT 框相邻采样帧读数不同的比例。
耗时口径:官方 3B / 7B 与 FastVR 每条单独起进程,耗时含模型加载(官方 3B 纯推理约 672.6 s);numz / E1 / FlashVSR+ 模型常驻,加载摊到每条 ≤ 0.72 s;ReCaVSR 的耗时按输出文件修改时间差估算。MediaKit 是云端 API,成本按 ¥0.10/条 API 价,未核实,不进入成本比较。
数据来源:week1 评测 v2(审核修正版),bicubic 换成无损版、耗时给 p10、火星文率改用 GT 可读子集。
三、分项结果:显著性与分语种
3.1 把"差多少"和"这个差算不算数"分开;3.2 把 94 条按语种切开。
3.1 相对官方 3B 的配对差值(94 条)
| 方法 | ΔAcc | ΔAcc_rd | Δ翻转率 | ΔPSNR | ΔLPIPS | Δ成本 ¥(p10) |
|---|---|---|---|---|---|---|
| numz 3B(lab) | +0.047 [+0.018, +0.079] ▲ | +0.050 [+0.021, +0.082] ▲ | −0.048 ▲ | +1.78 [+1.69, +1.87] ▲ | −0.028 ▲ | −0.608 |
| ★ numz 3B(wavelet) | +0.044 [+0.016, +0.076] ▲ | +0.046 [+0.018, +0.078] ▲ | −0.040 ▲ | +1.82 [+1.74, +1.92] ▲ | −0.029 ▲ | −0.609 |
| 官方 7B | +0.045 [+0.023, +0.070] ▲ | +0.047 [+0.025, +0.071] ▲ | −0.042 ▲ | +0.80 [+0.71, +0.88] ▲ | −0.010 ▲ | +0.062 |
| E1 无损 | 0 [0, 0] | 0 | 0 | 0 | 0 | −0.577 |
| E1 colorfix | +0.006 [−0.004, +0.015] | — | −0.002 | −0.50 [−0.58, −0.43] ▼ | −0.002 ▲ | −0.574 |
| bicubic(无损) | −0.078 [−0.123, −0.033] ▼ | — | +0.123 ▼ | +0.39 [+0.13, +0.66] ▲ | +0.144 ▼ | — |
| MediaKit | −0.091 [−0.142, −0.041] ▼ | — | +0.131 ▼ | −0.01 [−0.29, +0.27] | +0.055 ▼ | — |
| FastVR | −0.144 ▼ | — | +0.179 ▼ | −1.30 ▼ | +0.046 ▼ | −0.740 |
| FlashVSR+ Turbo | −0.167 [−0.230, −0.107] ▼ | −0.171 ▼ | +0.197 ▼ | −1.38 ▼ | +0.023 ▼ | −0.742 |
| FlashVSR+ Base | −0.187 ▼ | — | +0.225 ▼ | −2.63 ▼ | +0.035 ▼ | −0.729 |
| FlashVSR | −0.198 ▼ | — | +0.241 ▼ | −2.33 ▼ | +0.042 ▼ | −0.756 |
| ReCaVSR | −0.223 ▼ | — | +0.230 ▼ | −0.89 ▼ | +0.013 ▼ | −0.727 |
口径:先按视频求差,再对差值重抽样 10,000 次;▲ 区间不跨 0,▼ 同。成本差按 p10 算。
其他关键配对
| 对比 | ΔAcc | ΔPSNR |
|---|---|---|
| numz_lab − 官方 7B | +0.002 [−0.018, +0.023](Acc_rd +0.003 [−0.017, +0.024]) | +0.98 [+0.87, +1.09] ▲ |
| numz_wavelet − 官方 7B | −0.001 [−0.020, +0.018] | +1.03 [+0.92, +1.14] ▲ |
| numz_lab − numz_wavelet | +0.003 [−0.006, +0.013] | −0.046 [−0.077, −0.023] ▼ |
| MediaKit − bicubic(无损) | −0.014 [−0.038, +0.010] | −0.40 [−0.49, −0.32] ▼ |
| FastVR − bicubic(无损) | −0.066 [−0.109, −0.025] ▼ | −1.69 ▼ |
| FlashVSR − bicubic(无损) | −0.121 [−0.170, −0.073] ▼ | −2.72 ▼ |
| ReCaVSR − bicubic(无损) | −0.145 [−0.204, −0.087] ▼ | −1.28 ▼ |
| MediaKit − FastVR | +0.052 [+0.012, +0.096] ▲ | +1.29 ▲ |
3.2 分语种(Acc,94 条)
| 方法 | 中文(n=29) | 拉丁(n=48) | 中英混排(n=17) | 全量(n=94) | 混排与 GT 的差 |
|---|---|---|---|---|---|
| GT 原片(上限) | 0.885 | 0.831 | 0.747 | 0.832 | — |
| numz 3B(lab) | 0.853 | 0.820 | 0.622 | 0.794 | −0.125 |
| ★ numz 3B(wavelet) | 0.862 | 0.810 | 0.616 | 0.791 | −0.131 |
| 官方 7B | 0.879 | 0.817 | 0.573 | 0.792 | −0.174 |
| 官方 3B | 0.824 | 0.788 | 0.500 | 0.747 | −0.247 |
| E1 无损(= 官方 3B) | 0.824 | 0.788 | 0.500 | 0.747 | −0.247 |
| MediaKit | 0.765 | 0.710 | 0.318 | 0.656 | −0.429 |
| FlashVSR+ Turbo | 0.735 | 0.570 | 0.347 | 0.581 | −0.400 |
| FastVR | 0.754 | 0.612 | 0.322 | 0.604 | −0.425 |
| FlashVSR | 0.738 | 0.523 | 0.298 | 0.549 | −0.449 |
| ReCaVSR | 0.680 | 0.527 | 0.251 | 0.524 | −0.496 |
口径:同 94 条按标注语种切分,每格是该子集的 Acc 均值。分语种未做配对显著性检验:混排只有 17 条,单语种差异的区间很宽,表中数字只作方向参考。bicubic 一行在审核中换成了无损版(全量 0.669),分语种行仍是审核前的有损版(0.790 / 0.735 / 0.357),两者不可直接对齐。
四、典型场景:16 个案例 + 对比视频
4.1 逐案例对比图;4.2 同一段视频按方法分格。前 10 个案例来自 CTVid 实拍,后 6 个来自 AIGC / H3 生成。
4.1 逐案例对比图
图怎么做的:每个 case 的目标文字框是人工标注的 union box,按每个方法自己的几何(输出尺寸、上下裁切偏移)分别映射,再最近邻放大到同一尺寸、同一缩放系数拼接,方法名直接烧在图上;没有任何锐化、插值美化或对比度调整。卡片里的指标是该 case 自己的框内结果(展开可看逐模型数值),不是 94 条均值。静帧只在标注帧附近有效,个别 case 的招牌在片中有位移。
4.2 同一段视频,按方法分格
原生 <video>,无自动播放。每格方法名下的单价为 ¥/秒(素材 4 秒/条),按从左到右、从上到下阅读。
C0011 · 机场登机口「↓363-378 登机口 Gates」
canvas f30–f116 · 30fps · 1080pC0135 · 「UP TO 75% OFF MARKDOWNS」
canvas f20–f115 · 30fps · 1080pAIGC · H3 生成片「复核状态与批准所需具体条件」
pilot B4 · 24fps · 4× 上采样五、H3 生成视频上的超分
5.1 三个设置与 GT 构造;5.2 文字侧多指标;5.3 画质与内容改写;5.4 指标之间的不一致;5.5 样例。
5.1 三个设置与伪 GT 构造
| 设置 | 输入 | 输出 | 文字 GT | 像素 GT | 条数 / 语言 |
|---|---|---|---|---|---|
| N480 | H3 原生 480p(832×480) | 1872×1080(×2.25) | prompt 原文 + 原生输入 OCR 过滤 | 无 | 40 · 英文 |
| N768 | H3 原生 768p(1344×768) | 1890×1080(×1.406) | 同上 | 无 | 40 · 英文 |
| S768 | 降采样 832×480 + H.264 crf23 | 1344×768(×1.615) | 同上 | 有(H3 原生 768p) | 40 · 中 24 / 日 4 / 英 12 |
命名:表里的 numz 版 3B 指 1.1 里的社区 ComfyUI 实现 + 本项目加速改动;官方 3B 指 SeedVR2 原仓库。
伪 GT 构造:标签用 H3 生成时的 prompt 原文;再对原生输入做 OCR,只保留本来就能读出来的目标串(NED ≥ 0.7),把"生成时就已糊掉的字"排除在评测之外。因此这里量的是"放大有没有把本来可读的字弄坏",不是 H3 的文字能力。伪 GT 的框随方法输出尺寸等比缩放。
5.2 文字侧多指标
| 方法 | N480 · 480p→1080(英文,无像素 GT) Acc↑ / NED↑ / CER↓ / Det↑ / 漏读↓ / 高置信错↓ / 严重错↓ / 翻转率↓ | N768 · 768p→1080(英文,无像素 GT) Acc↑ / NED↑ / CER↓ / Det↑ / 漏读↓ / 高置信错↓ / 严重错↓ / 翻转率↓ | S768 · 480p→768p(有像素 GT,中/日/英) Acc↑ / NED↑ / CER↓ / Det↑ / 漏读↓ / 高置信错↓ / 严重错↓ / 翻转率↓ | 备注 | |||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| H3 原生输入(未放大) | 0.202 | 0.818 | 0.182 | 0.994 | 0.006 | 0.033 | 0.0 | 0.66 | 0.266 | 0.859 | 0.141 | 1.0 | 0.0 | 0.015 | 0.002 | 0.565 | 0.57 | 0.838 | 0.162 | 0.971 | 0.029 | 0.029 | 0.026 | 0.372 | |||||||
| GT 原片 | — | — | 0.58 | 0.889 | 0.111 | 1.0 | 0.0 | 0.018 | 0.001 | 0.382 | |||||||||||||||||||||
| Bicubic | 0.174 | 0.79 | 0.21 | 0.99 | 0.01 | 0.015 | 0.032 | 0.716 | 0.271 | 0.839 | 0.161 | 0.996 | 0.004 | 0.019 | 0.001 | 0.571 | 0.548 | 0.851 | 0.149 | 0.969 | 0.031 | 0.02 | 0.004 | 0.405 | |||||||
| FastVR | 0.127 | 0.762 | 0.238 | 0.985 | 0.015 | 0.038 | 0.01 | 0.756 | 0.248 | 0.814 | 0.186 | 0.996 | 0.004 | 0.015 | 0.003 | 0.616 | 0.514 | 0.756 | 0.243 | 0.976 | 0.024 | 0.014 | 0.04 | 0.458 | |||||||
| FlashVSR v11 | 0.142 | 0.771 | 0.229 | 0.988 | 0.012 | 0.052 | 0.005 | 0.718 | 0.199 | 0.774 | 0.226 | 0.997 | 0.003 | 0.031 | 0.006 | 0.649 | 0.453 | 0.693 | 0.307 | 0.996 | 0.004 | 0.012 | 0.096 | 0.503 | |||||||
| FVP Turbo | 0.144 | 0.781 | 0.219 | 1.0 | 0.0 | 0.064 | 0.003 | 0.729 | 0.22 | 0.802 | 0.198 | 0.995 | 0.005 | 0.021 | 0.006 | 0.652 | 0.46 | 0.695 | 0.305 | 0.973 | 0.027 | 0.01 | 0.084 | 0.487 | |||||||
| ReCaVSR | 0.094 | 0.66 | 0.34 | 0.985 | 0.015 | 0.043 | 0.02 | 0.801 | 0.073 | 0.539 | 0.461 | 0.986 | 0.014 | 0.021 | 0.075 | 0.842 | 0.324 | 0.546 | 0.454 | 0.953 | 0.047 | 0.004 | 0.319 | 0.619 | |||||||
| 官方 3B | 0.222 | 0.805 | 0.195 | 0.995 | 0.005 | 0.017 | 0.002 | 0.579 | 0.203 | 0.827 | 0.173 | 0.986 | 0.014 | 0.026 | 0.0 | 0.493 | 0.531 | 0.78 | 0.22 | 0.991 | 0.009 | 0.044 | 0.027 | 0.417 | |||||||
| numz 版 3B | 0.186 | 0.834 | 0.166 | 1.0 | 0.0 | 0.045 | 0.0 | 0.549 | 0.254 | 0.832 | 0.168 | 0.995 | 0.005 | 0.032 | 0.0 | 0.584 | 0.481 | 0.772 | 0.228 | 0.988 | 0.013 | 0.037 | 0.012 | 0.454 | |||||||
| numz 版 7B | 0.231 | 0.819 | 0.181 | 0.996 | 0.004 | 0.043 | 0.0 | 0.638 | 0.115 | 0.788 | 0.212 | 0.99 | 0.01 | 0.07 | 0.008 | 0.62 | 0.559 | 0.783 | 0.217 | 0.984 | 0.016 | 0.004 | 0.01 | 0.4 | |||||||
| (该格覆盖的 clip 数) | 40 | — | 40 | 40 | 40 | 40 | 40 | 20 | 40 | 20 | 40 | — | 40 | 40 | 40 | 40 | 40 | 20 | 40 | 19 | 40 | 40 | 40 | 40 | 40 | 40 | 40 | 20 | 40 | 20 | |
口径:每 4 帧采样一次 OCR;Acc = 归一化后完全相等;NED = 1 − 归一化编辑距离;CER = 字符错误率(独立重算,与 NED 互为对照);Det = 在目标框内检测到文字行的比例;漏读 = 框内没有任何文字行;高置信错 = conf ≥ 0.8 却 NED < 0.5;严重错 = NED < 0.2;翻转率 = 同一目标相邻采样帧读数不同。先在 clip 内求平均,再对 clip 求平均。
5.3 画质与内容改写
(a)S768:输出 vs 像素 GT(唯一的真画质分)
每 8 帧取一帧 · 1344×768| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | DISTS ↓ | 样本 |
|---|---|---|---|---|---|
| Bicubic | 33.67 | 0.9517 | 0.0715 | 0.053 | 40 条 |
| FastVR | 23.89 | 0.8281 | 0.1032 | 0.0674 | 40 条 |
| FlashVSR v11 | 27.24 | 0.8709 | 0.1121 | 0.0733 | 40 条 |
| FVP Turbo | 23.19 | 0.7975 | 0.1114 | 0.0657 | 40 条 |
| ReCaVSR | 23.48 | 0.8036 | 0.1323 | 0.0882 | 40 条 |
| 官方 3B | 22.78 | 0.8147 | 0.1271 | 0.0746 | 20 条 |
| numz 版 3B | 23.4 | 0.8168 | 0.1171 | 0.0721 | 40 条 |
| numz 版 7B | 24.18 | 0.832 | 0.1045 | 0.0609 | 20 条 |
| 方法 | N480 · 480p→1080(英文,无像素 GT) LPIPS↓ / DISTS↓ | N768 · 768p→1080(英文,无像素 GT) LPIPS↓ / DISTS↓ | S768 · 480p→768p(有像素 GT,中/日/英) LPIPS↓ / DISTS↓ | |||
|---|---|---|---|---|---|---|
| Bicubic | — | — | — | — | 0.0334 | 0.0336 |
| FastVR | 0.1636 | 0.1437 | 0.1105 | 0.0698 | 0.1385 | 0.0805 |
| FlashVSR v11 | 0.1847 | 0.1554 | 0.123 | 0.0849 | 0.1531 | 0.0972 |
| FVP Turbo | 0.1868 | 0.153 | 0.1147 | 0.0774 | 0.1482 | 0.0888 |
| ReCaVSR | 0.1706 | 0.1397 | 0.1053 | 0.0693 | 0.136 | 0.0864 |
| 官方 3B | 0.2157 | 0.1555 | 0.1254 | 0.0783 | 0.1652 | 0.095 |
| numz 版 3B | 0.1756 | 0.1581 | 0.1179 | 0.0868 | 0.1646 | 0.1052 |
| numz 版 7B | 0.168 | 0.1465 | 0.0989 | 0.0736 | 0.146 | 0.0916 |
(b)输出 vs 原生输入:内容改写量(越小越忠实)
输出降采样回原生分辨率后与原生输入比口径:(a) PSNR(RGB)、SSIM(Y-gaussian)、LPIPS(alex)、DISTS,输出与 S768 像素 GT 全参考比对,只有 S768 有像素 GT,N480 / N768 没有画质结论。(b) 把输出降采样回原生分辨率后与原生输入比:纯插值回环应接近 0,生成式模型会凭空造像素,所以这一列不是画质分,是"模型把画面改了多少"的代理。
5.4 各指标给出的排序并不一致
S768 上 Acc 的排序是 numz 版 7B 0.559 > Bicubic 0.548 > 官方 3B 0.531 > FastVR 0.514 > numz 版 3B 0.481 > FVP Turbo 0.460 > FlashVSR v11 0.453 > ReCaVSR 0.324;同一批 clip 上 Det F1 的排序是 FlashVSR v11 0.996 > 官方 3B 0.991 > numz 版 3B 0.988 > numz 版 7B 0.984 > FastVR 0.976 > FVP Turbo 0.973 > Bicubic 0.969 > ReCaVSR 0.953。两列排序不一致:Acc 最低的是 ReCaVSR(0.324),它在 Det 上也是最低(0.953);Det 最高的是 FlashVSR v11(0.996),它的 Acc 只有 0.453,在 Acc 上排第 7 / 8。
严重错读率(NED<0.2,整行基本读不出):Bicubic 0.004、numz 版 7B 0.010、numz 版 3B 0.012、官方 3B 0.027、FastVR 0.040、FVP Turbo 0.084、FlashVSR v11 0.096、ReCaVSR 0.319。
高置信错读率(conf≥0.8 却读错):ReCaVSR 0.004、numz 版 7B 0.004、FVP Turbo 0.010、FlashVSR v11 0.012、FastVR 0.014、Bicubic 0.020、numz 版 3B 0.037、官方 3B 0.044。
跨帧翻转率(同一框相邻采样帧读数不同):numz 版 7B 0.400、Bicubic 0.405、官方 3B 0.417、numz 版 3B 0.454、FastVR 0.458、FVP Turbo 0.487、FlashVSR v11 0.503、ReCaVSR 0.619。
N480 上 numz_3b 的 Acc 0.186 与 bicubic 的 0.174 相比(高),且 NED 是 0.834 vs 0.790(更好)。
同一对方法,严重错读率是 0.000 vs 0.032。
N768 上 numz_3b 的 Acc 0.254 与 bicubic 的 0.271 相比(低),且 NED 是 0.832 vs 0.839(更差)。
同一对方法,严重错读率是 0.000 vs 0.001。
说明:上面每条都是本表数据的直接读数,没有加权、没有综合分。是否用哪个指标、或者用哪几个指标的组合,属于需要人来定的部分。
5.5 样例
S768 · H3 自生成中文片
H3SG-005185 · f16 · 目标字「智界R7」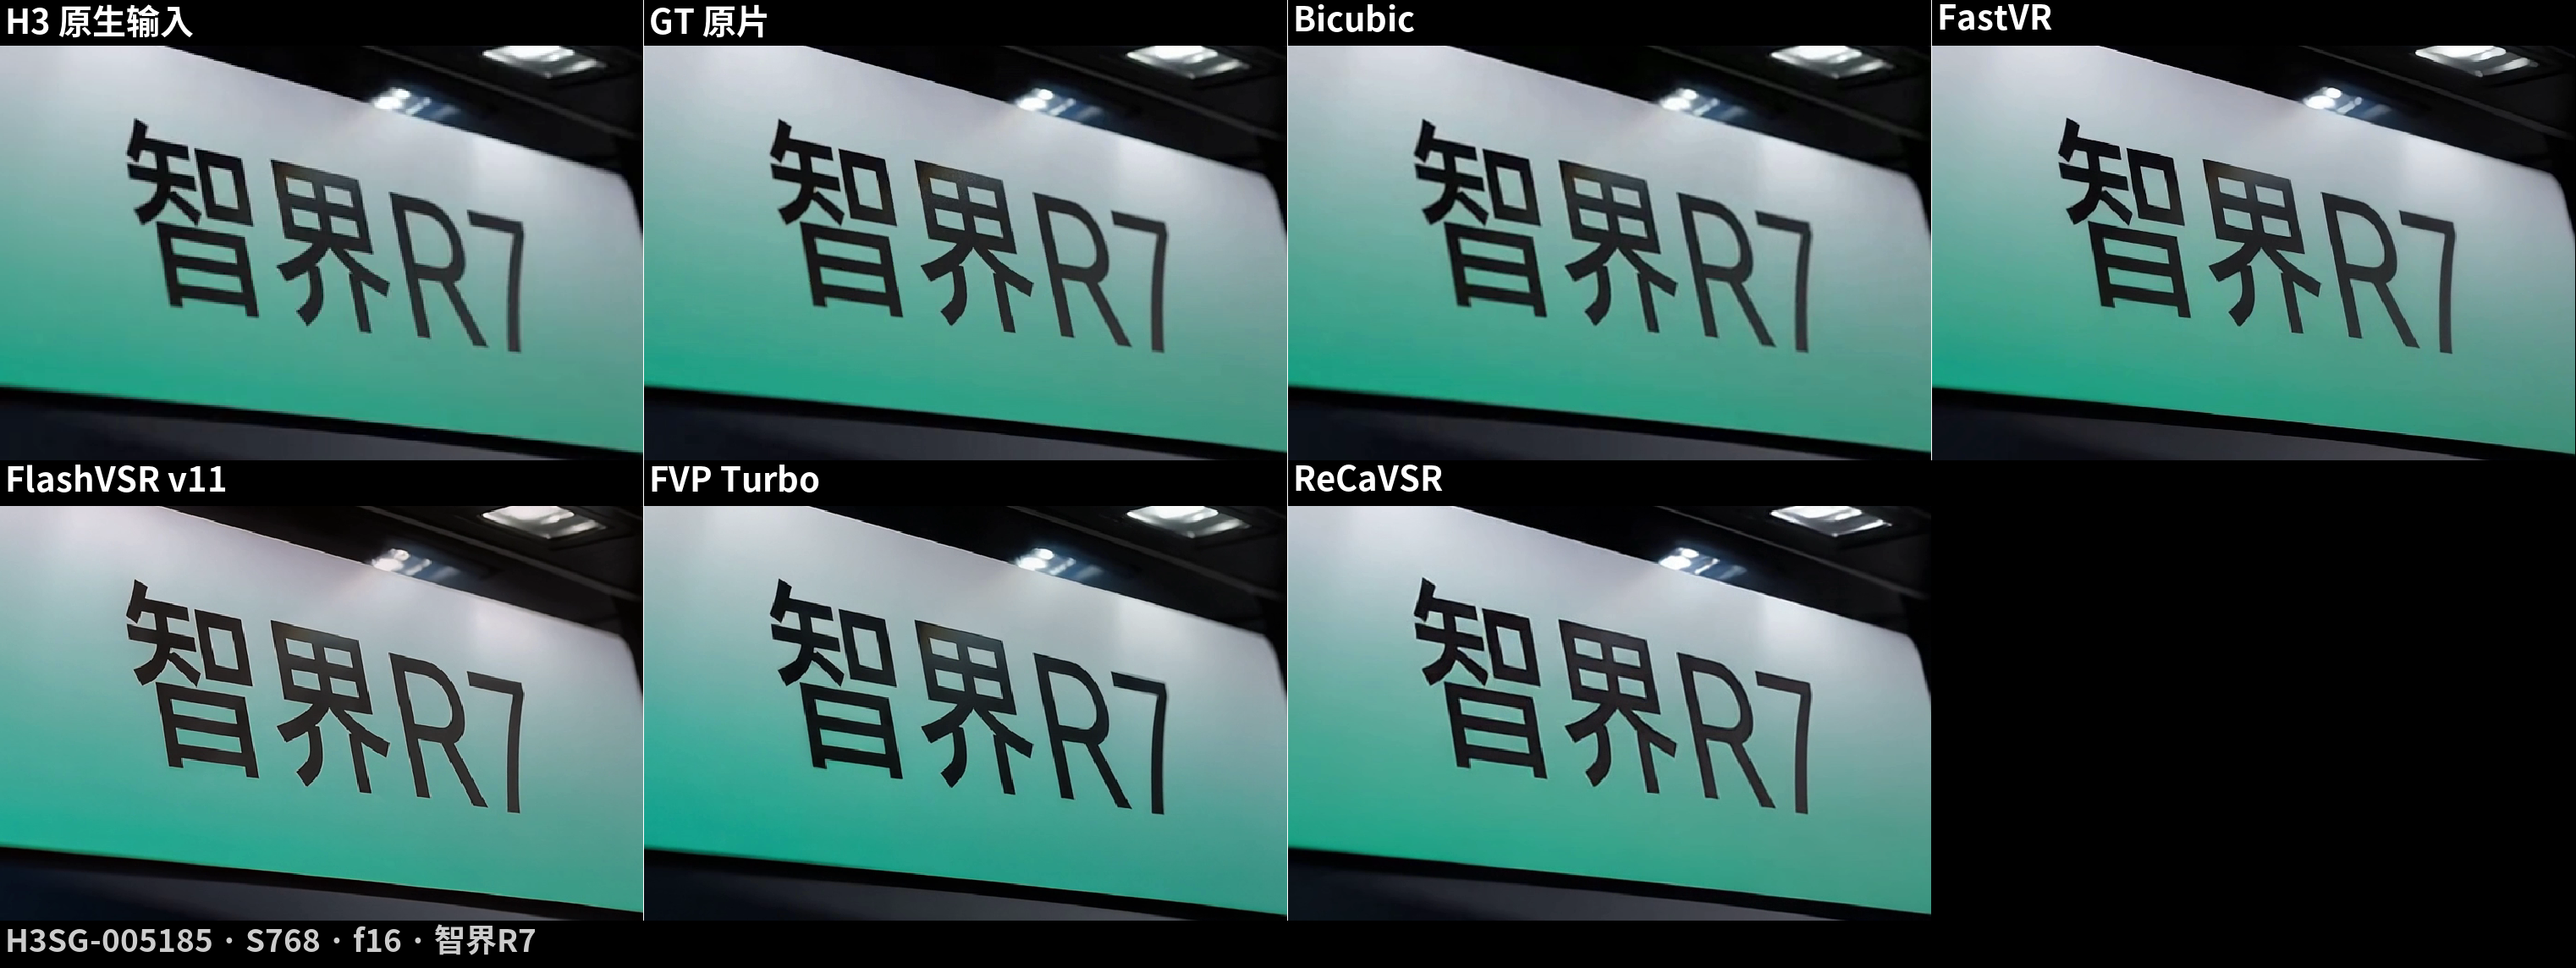
每格是同一块文字在各自几何里的裁切,最近邻放大,方法名烧在图上:H3 原生输入 / GT 原片 / Bicubic / FastVR / FlashVSR v11 / FVP Turbo / ReCaVSR。
N768 · H3 原生 768p 英文片
UI-0013 · f8 · 目标行「Q: Why not order copper earlier? …」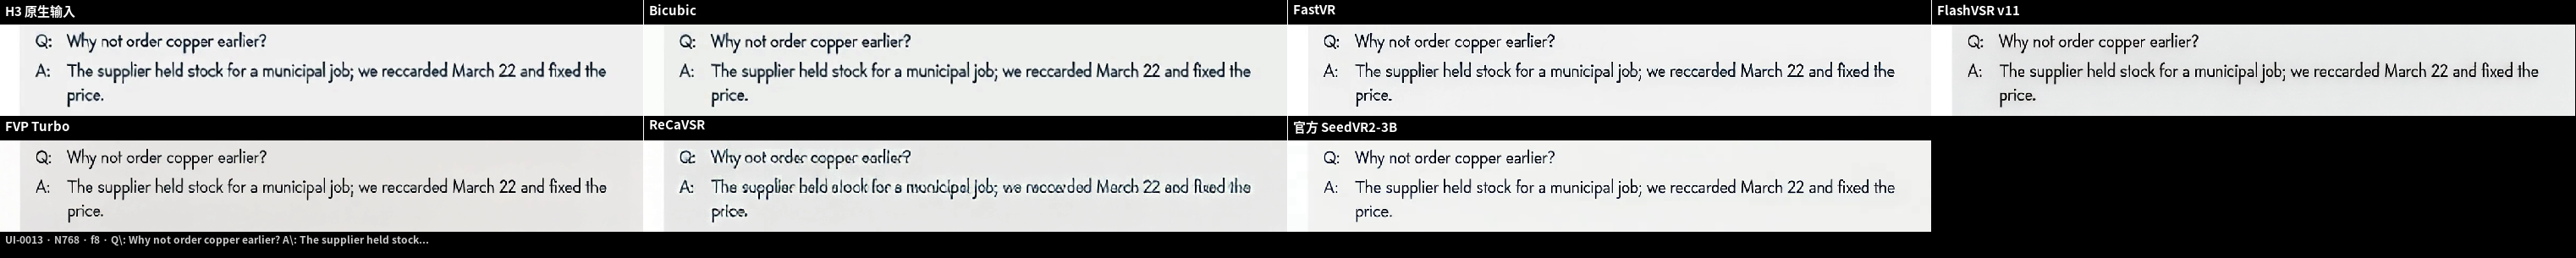
同一行文字在 768p 原生片上被各模型放大到 1080 高:H3 原生输入 / Bicubic / FastVR / FlashVSR v11 / FVP Turbo / ReCaVSR / 官方 3B。
六、成本与路由
6.1 三档成本(按"有没有字"分流的成本模型);6.2 廉价路各方法的实测对照。
6.1 三档成本
| 档位 | 单条成本 | 文字(Acc) |
|---|---|---|
| 经济档:全部走 FlashVSR+ Turbo,文字 ROI 回退 bicubic | ¥0.035–0.042 | Turbo 0.581;回退上限至少是 bicubic 0.669(回退收益待测) |
| 均衡档 | p=0.3:¥0.075–0.083 p=0.5:¥0.10–0.11 p=1:¥0.168–0.177 | 有字片段 0.791(GT 0.832) |
| 质量档:均衡档 + 文字 LoRA | ≈ 均衡档 | LoRA 尚未训练,无数据 |
| 对照:官方 3B | ¥0.78 | 0.747 |
| 对照:官方 7B | ¥0.84–0.92 | 0.792 |
| 对照:MediaKit | ¥0.10(API 价,未核实) | 0.656 |
口径:总成本 = (1−p)·c_廉价 + p·c_文字,p = 有字片段占比;c 取 p10 与均值两档。S0 文字探测在 CPU 上做,GPU 开销约为 0。原写法 "0.02 + 0.17·p" 低估了无字路成本,已改成上式。
成本单位:素材为 4 秒/条(120 帧 @30fps),¥/秒 = ¥/条 ÷ 4。摘要、散点图与结论用 ¥/秒;本节与上面的主表保留实测的 ¥/条(墙钟本来就按条计)。
6.2 廉价路方法的成对对照(94 条)
| 对比 | ΔAcc | Δ翻转率 | ΔPSNR | ΔLPIPS | p10 成本 |
|---|---|---|---|---|---|
| FlashVSR+ Turbo − bicubic(无损) | −0.089 [−0.137, −0.043] ▼ | — | — | — | ¥0.035 vs ≈0 |
| FlashVSR+ Turbo − FlashVSR v1 | +0.032 [+0.012, +0.051] ▲ | −0.044 ▲ | +0.95 [+0.69, +1.18] ▲ | −0.019 ▲ | ¥0.035 vs ¥0.021 |
| FastVR − FlashVSR+ Turbo | +0.023 [−0.002, +0.050] | — | +0.08 | +0.023 ▼ | ¥0.037 vs ¥0.035 |
| ReCaVSR − FlashVSR+ Turbo | −0.056 | — | +0.49 [+0.27, +0.73] ▲ | −0.010 ▲ | ¥0.050 vs ¥0.035 |
| FlashVSR+ Base − FlashVSR+ Turbo | −0.021 | — | −1.25 [−1.39, −1.12] ▼ | — | ¥0.048 vs ¥0.035 |
| FlashVSR+ Turbo 与 MediaKit 的 NED | 0.871 vs 0.898 | — | — | — | ΔNED −0.027 [−0.051, −0.003] ▼ |
口径:配对差值,94 条,▲/▼ 同 1.3。ReCaVSR 的耗时含每条模型加载,常驻后可能更快。
6.3 成本-质量散点:哪些点没被同时压过
Acc / 成本 · CTVid 94 条 · 评测 v2(横轴对数)
七、SeedVR2 加速链路
同一条 4 秒 / 120 帧 / 1080p 片段,单卡 4090,每一步只改一个变量。
单条墙钟时间
单位:秒 · 越短越好7.2 时间花在哪儿:算子级归因(nsys,101.4 s 配置)
| 阶段 | GPU kernel 时间 | 占比 | 其中最大的两类 |
|---|---|---|---|
| VAE decode(1080p 重建) | 82.5 s | 60.7% | conv 34.9 s · copy 27.3 s |
| VAE encode(降采样到 latent) | 30.4 s | 22.4% | conv 13.3 s · copy 9.3 s |
| DiT(3B 主干) | 21.8 s | 16.1% | GEMM 7.7 s · elementwise 8.0 s |
| 后处理(写 mp4 等) | 1.2 s | 0.9% | — |
| 合计 | 135.97 s | 100% | conv_igemm 35.5% · copy 27.4% · add 10.8% · gemm 6.4% |
口径:nsys trace 的 kernel 时间归因(NVTX 分段),覆盖 warmup + measured 两个文件,所以合计 135.97 s 大于单条墙钟 101.4 s。占比按 kernel 时间算,不是墙钟。
7.3 算子有没有到 roofline 的高峰
| 算子(decode 三个主 conv) | 调用次数 | 合计 TFLOP | 实测 TFLOPS | 占实测峰值 | 算术强度 | 受限类型 |
|---|---|---|---|---|---|---|
| Conv3d (512,6,79,962) → 512 | 145 | 606.9 | 149.4 | 91.0% | 5340 FLOP/B | 算力受限,到顶 |
| Conv3d (256,6,138,962) → 256 | 290 | 536.0 | 137.6 | 83.8% | 2723 FLOP/B | 算力受限 |
| Conv3d (128,6,183,963) → 128 | 580 | 357.0 | 116.3 | 70.8% | 1369 FLOP/B | 算力受限 |
| Conv3d 1×1×1 (256,5,544,960) → 1024 | 1 | 1.4 | 0.4 | 0.3% | 205 FLOP/B | 带宽受限 |
| 全部 conv 合计 | — | 8221.8 | — | — | — | 67.0 s |
峰值口径:4090 的 bf16 峰值是实测的,不是标称:GEMM 164.2 TFLOPS(16384 尺寸,实测;4096 尺寸只有 145.5)、拷贝 916.8 GB/s(理论 1008 GB/s 的 91%)。来源 ~/week2/vae_opt2/profile_gpu/results/gemm_peak.json。
| ncu 计数器(上面第一个 conv,12 次 launch) | 值 | 含义 |
|---|---|---|
| tensor pipe(HMMA) | 48.8% of peak | 这是 fp16-accumulate 的峰值口径;本 kernel 是 bf16 in / fp32 out,约等于 fp32-accumulate 峰值的 97% |
| DRAM 吞吐 | 11.9% | 算子不靠显存带宽,是算力受限 |
| SM 吞吐 | 48.3% | — |
| L2 命中率 | 96.7% | 几乎不访存 DRAM |
| 占用率 / 寄存器 | 8.3% · 254 reg/thread | 占用率低是卷积 tile 本身的选择(一个 thread 负责一整块输出),不是调优空间 |
ncu 的边界:这台机器的 RmProfilingAdminOnly=1,性能计数器需要 root 才能采(ERR_NVGPUCTRPERM)。上表的计数器来自 ~/week2/vae_opt2/ncu/micro_full.ncu-rep(root 跑的 micro 探针,同形状 12 次 launch);管线的 e2e 采样脚本在 ~/week2/vae_opt2/ncu/run_ncu.sh(sudo bash run_ncu.sh 0 e2e),要补管线级 SOL 需要 root 再跑一次。
7.4 搬运:带宽够用,问题在次数
| 搬运方向 | 数据量 | 次数 | 时间 | 实际带宽 | 中位单包 | 参照 |
|---|---|---|---|---|---|---|
| Host → Device(权重 offload) | 7.58 GB | 9,479 | 1.83 s | 4.1 GB/s | 0.8 MB | PCIe 4.0 x16 理论 31.5 GB/s |
| Device → Host | 7.49 GB | 1,495 | 4.03 s | 1.9 GB/s | 1 KB | |
| Device → Device(卡内搬运) | 15.24 GB | 135 | 0.033 s | 462 GB/s | 113 MB | 实测拷贝峰值 916.8 GB/s |
读法:卡内搬运跑到实测峰值的 50%,卡间(PCIe)只跑到 5–13%——瓶颈不是带宽,是次数多、包小:Device→Host 的中位单包只有 1 KB,9,479 次 H2D 每次 0.8 MB。对应的方向是减少搬运次数与数据量(权重常驻、FP8、合并搬运),而不是"跑得更快"。pipe_patch 的 KEEP_RESIDENT 一项(把模型 offload 关掉)实测 DiT 阶段 25.0 → 22.1 s,也是同一个结论。
八、公开文字 LoRA 检索
8.1 扫描范围与结果;8.2 能加载的两个 LoRA 的实测;8.3 自研训练的可训练性探针。
8.1 扫描范围
| 渠道 | 扫描量 | 文字专用 LoRA | 说明 |
|---|---|---|---|
| ComfyUI 包 | 6,131 | 0 | 全量扫描 |
| ModelScope SeedVR2 仓库 | 45 | 0 | — |
| FlashVSR 仓库 | 9 | 0 | — |
| 能加载到 SeedVR2 / FlashVSR 的 LoRA 权重 | 2 | 0 | 均为 AGPL-3.0;一个对文字中性到更差,一个无可测变化 |
结论(已写入 RESULT.json):no existing text-focused LoRA or finetune for SeedVR2/FlashVSR/FastVR/ReCaVSR qualifies;committed: false。
8.2 两个可加载 LoRA 与 rank-16 注入通道的实测
| 配置 | 许可 | C0011 Acc | C0011 NED | C0011 翻转率 | AIGC 2 条 Acc | AIGC 2 条 NED |
|---|---|---|---|---|---|---|
| 官方 3B 对照 | Apache-2.0 | 0.867 | 0.988 | 0.138 | 0.073 | 0.740 |
| 3B + 自研 rank-16(探针权重,未训练) | Apache-2.0 + 自训 | 0.833 | 0.984 | 0.276 | 0.056 | 0.775 |
| FlashVSR v1.1 base | Apache-2.0 | 0.000 | 0.498 | 1.000 | 0.006 | 0.675 |
| FlashVSR + Lada LoRA | AGPL-3.0 | 0.000 | 0.511 | 1.000 | 0.039 | 0.688 |
| bicubic(AIGC 2 条对照) | — | — | — | — | 0.157 | 0.796 |
口径:C0011 为单条 CTVid(Acc/NED/翻转率同 1.2 口径);AIGC 为 N768 的 2 条(UI-0003 + SCI-0002,211 个实例),区间见 RESULT.json。样本量很小,只作通道可用性记录,不构成方法优劣结论。合并情况:Lada/SeedVR2 160/160 目标匹配,Lada/FlashVSR 180/180 匹配但官方 diffsynth loader 返回 0 个目标。
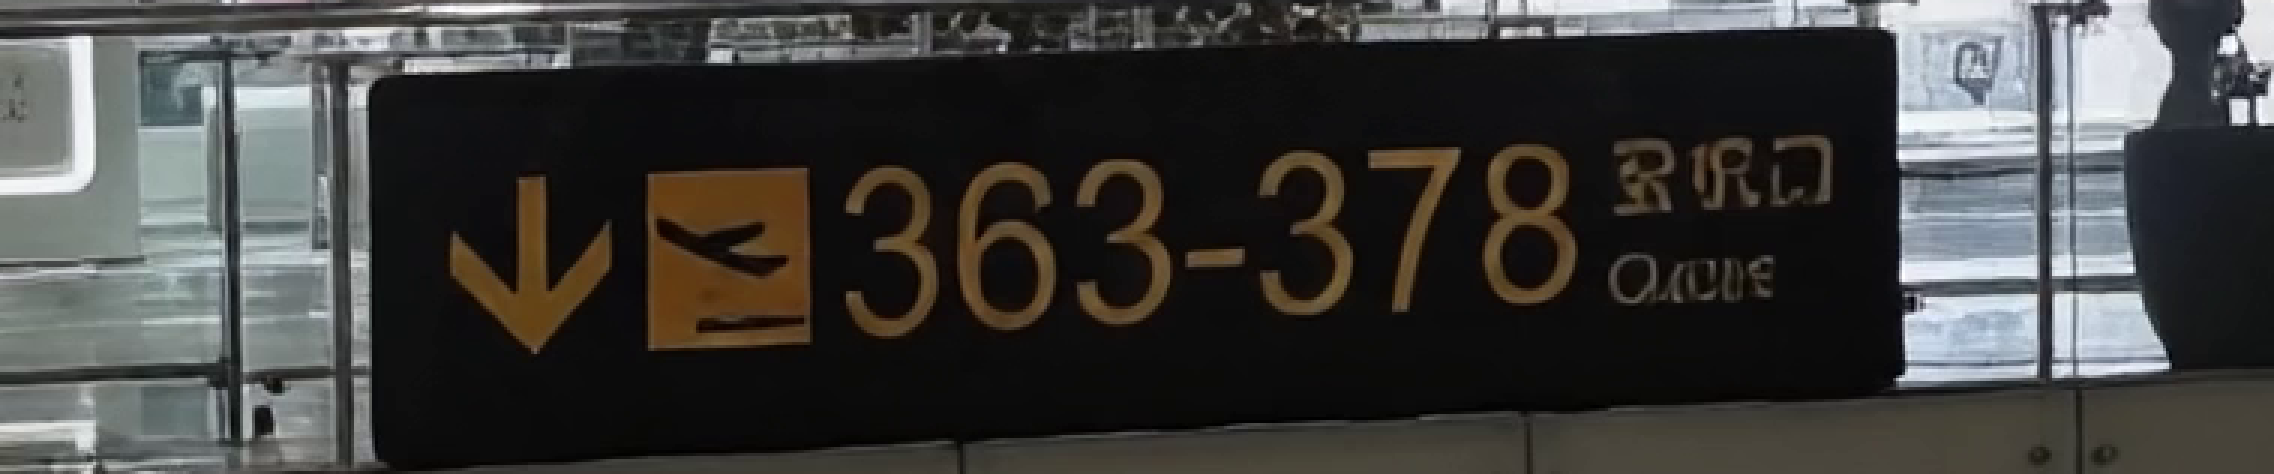 FlashVSR base
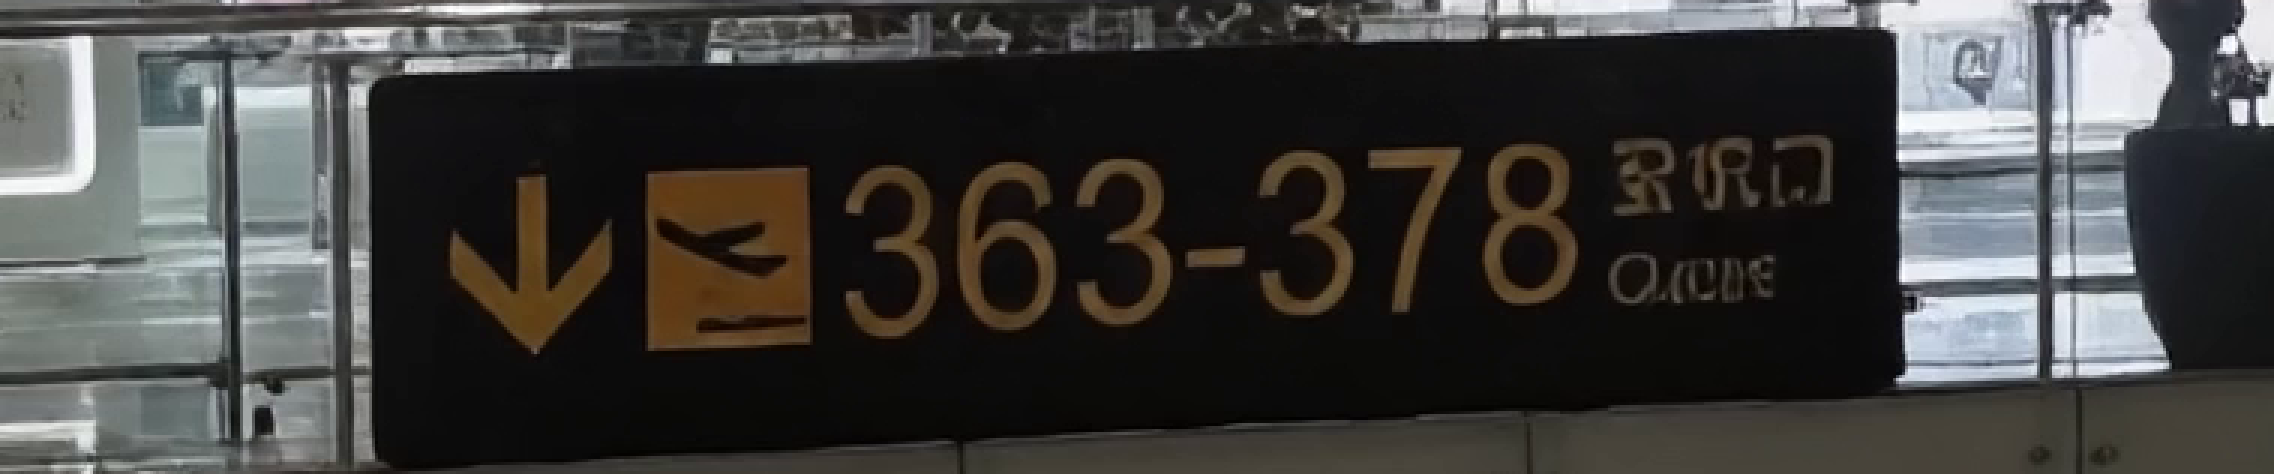 + Lada LoRA
 SeedVR2 对照
 rank-16 探针
8.3 自研训练的可训练性探针
| 项 | 值 | 说明 |
|---|---|---|
| 基座 / LoRA rank | 官方 3B / 16(160 个 target) | — |
| 可训练参数 | 22,413,312(占 0.66%) | — |
| 256px / 36f | 0.398 s/step,峰值 16.84 GiB | — |
| 384px / 36f | 1.052 s/step | — |
| 512px | OOM | 需切分或降低窗口 |
| 20k steps | ≈ 5.8 GPU-hours | 不含数据与评测 |
状态:探针只测"能不能训、显存够不够、步速多快",没有正式训练,也没有收益数据。
九、相对上一版报告(2026-10-16)的更正
上一版《MediaKit 视频增强实测报告》用 Apple Vision OCR、每条 3 帧,PSNR/SSIM 的计算方式与本版不同。下面是逐条对照,数字以本版为准。
| 上一版的说法 | 本版实测 | 差异 |
|---|---|---|
| “MediaKit 像素保真最高” | 上一版把官方 SeedVR2 的 1072 行、FlashVSR 的 1024 行直接插值拉伸到 1080 行再算 PSNR/SSIM。按实际对应的 GT 行对齐后:官方 3B 27.49 / 0.865 / 0.136(上一版 23.85 / 0.796 / 0.147),FlashVSR 25.15 / 0.791 / 0.179(上一版 16.28 / 0.602 / 0.351),MediaKit 27.48 / 0.868 / 0.192,FastVR 26.18 / 0.823 / 0.183 | MediaKit 与官方 3B 的 PSNR(Δ −0.01)、SSIM(+0.003)打平;3B 的 LPIPS / DISTS 领先 0.055 / 0.052 |
| “FlashVSR 保真明显弱(PSNR 16.3)” | 25.15 | 仍最低,但比 3B 低 2.3 dB,不是 7.6 dB |
| “MediaKit 放大确实恢复了文字,不是纯锐化滤镜” | 相对它自己的不放大版确实更好;相对 bicubic 文字无显著差异(−0.014 [−0.038, +0.010]),PSNR 低 0.40 dB,只有 LPIPS 更好(−0.089) | 上一版没有 bicubic 基线 |
| “FastVR 均衡:文字 0.721 接近 MediaKit” | FastVR 显著低于 bicubic(−0.066 [−0.109, −0.025]),也显著低于 MediaKit(−0.052 [−0.096, −0.012]) | 排序变化 |
| “MediaKit 拉丁文第一” | 拉丁 Acc:MediaKit 0.710,官方 3B 0.788,配对差值 −0.078 [−0.153, −0.008] | 不成立 |
| “官方 3B 705 s、¥0.78,单价约 MediaKit 的 8 倍” | 同样输出用 E1 是 ¥0.214(逐位一致),numz 是 ¥0.177(Acc 0.791,比官方 3B 高 0.044) | 文字路单价变为 MediaKit 的约 1.7–2.1 倍 |
| “52/94 条四家并列,差距很小” | 旧指标(RapidOCR best_sim)下方法间跨度 0.058;本版 Acc 跨度 0.270。两套指标 Spearman ρ = 0.978、Kendall τ = 0.922 | 方向一致,分辨力不同 |
| (未涉及) | 本版新增:SeedVR2 加速链路 7.0×、公开文字 LoRA 检索、H3 生成视频矩阵、16 个案例对比图 | 新增量 |
附带澄清:上一版所有 SeedVR2 结果都未经过 color fix(脚本缺失);补上后 ΔAcc +0.006 [−0.004, +0.015] 不显著、PSNR 反而低 0.50 dB,缺 color fix 不影响上一版的文字结论。上一版的素材托管在 /tmp 下,重启会丢;本版素材已落到 report_assets/。
十、初步结论(供讨论,待复核)
10.1 数据直接支持的读数;10.2 局限;10.3 需要人来定的几件事。
10.1 数据直接支持的读数
文字:numz 与 7B 在同一档,numz 便宜约 5 倍
numz_wavelet Acc 0.791、numz_lab 0.794、官方 7B 0.792,三者两两配对差值区间都跨 0;单条成本(¥/秒)分别是 ¥0.044 / ¥0.044 / ¥0.229。numz 相对官方 3B 的 ΔAcc +0.044 [+0.016, +0.076] 显著。见 2、3.1
廉价模型的文字都低于 bicubic
FastVR −0.066、FlashVSR −0.121、ReCaVSR −0.145、FlashVSR+ Turbo −0.089(均对 bicubic 无损版,显著)。见 3.1、6.2
混排(中英同框)是最弱的一档
GT 自身 0.747;官方 3B 0.500、numz_wavelet 0.616、numz_lab 0.622、MediaKit 0.318、FlashVSR 0.298。见 3.2
加速链路已到 7.0×,且最后一步逐位一致
705.5 s → 101.4 s,单条成本 ¥0.196 → ¥0.028/秒;101.4 s 是单条单次实验,94 条 A/B 未做。见 7
公开渠道没有可用的文字 LoRA
6,131 + 45 + 9 个仓库扫描,0 个文字专用;能加载的 2 个是 AGPL-3.0,文字指标中性到更差。见 8
H3 生成视频上,各超分模型的文字指标排序与画质排序不一致
S768 上 Acc 最高的是 Bicubic(0.548),而 Det F1 最高的是 FlashVSR v11(0.996);严重错读率(NED<0.2)从 bicubic 的 0.004 到 ReCaVSR 的 0.319;同一批 clip 上原生输入 0.570、bicubic 0.548、官方 3B 0.531。见 5.2、5.3、5.4
10.2 局限
所有结果来自单卡 4090、4 秒 / 120 帧 / 1080p;更长视频要分段,numz 的整段窗口优势可能缩小。GT Acc 0.832 是平均意义上的上限,不是逐条上限。
|ΔAcc| < 0.02 落在编码噪声内;7B 相对 numz 的 +0.001 不构成质量优势。分语种没有做配对检验,混排只有 17 条。
101.4 s 是单条单次实验,未做 94 条 A/B;默认方案仍按 159.1 s 记账。numz 与官方 3B 的编码不同(mpeg4 ≈35 Mbps vs h264 ≈18 Mbps),PSNR 领先的 1.8 dB 里编码与色偏的贡献未拆开。
H3 矩阵里 numz 3B 三组已全部跑满(各 40 条);numz 7B 与官方 3B 各只跑了约 20 条(表内已标注),N480 / N768 没有像素 GT,PSNR / SSIM 不构成画质结论。
公开渠道没有文字 LoRA;自研 rank-16 只做到可训练性探针,没有训练也没有收益数据。H3 官方 API(用法 A / B)本机无 key,零指标。
“小字召回 18%”是 2026-10-16 的 RapidOCR 旧口径,不与本版 Acc 混用;本版未复跑无参考画质指标与 VLM 下游问答。
10.3 需要人来定的几件事
线上文字路用哪个方案
候选:numz_wavelet(Acc 0.791,¥0.044/秒)、numz_lab(0.794,¥0.044/秒)、官方 7B(0.792,¥0.229/秒)、E1 无损(0.747,¥0.054/秒,94/94 逐位等于官方 3B)。三者文字在噪声内,差别在成本与画质。数据:2、3.1
加速链路什么时候切默认
需要 94 条 A/B + 与 numz_wavelet 的非劣检验;在此之前默认是 159.1 s / ¥0.044/秒,还是先按 101.4 s / ¥0.028/秒 记账。数据:7
无字片段走哪条廉价路,文字回退到哪
候选:FlashVSR+ Turbo(¥0.011/秒,Acc 0.581)、FlashVSR(¥0.006/秒,0.549)、FastVR(¥0.011/秒,0.604)、ReCaVSR(¥0.016/秒,0.524);文字回退源候选:bicubic(0.669)还是 MediaKit(0.656,与 bicubic 无显著差异)。回退收益尚未实测(oracle 上限未算)。数据:3.1、6.1、6.2
文字修复走不走自研,验收线定多少
公开渠道已穷尽;自研 rank-16 可训(22,413,312 参数 / 0.66%,384px 1.052 s/step,512px OOM,20k steps ≈ 5.8 GPU-h)。验收线定在 Acc +0.02 还是更高,是口径问题,不是技术问题。数据:8
H3 生成视频要不要单独定规则
本版数据里,生成片上各超分模型的文字指标都不高于 bicubic;同时各指标排序互相矛盾(Acc / Det / 严重错读 / 翻转率)。若业务里有 H3 生成的素材,需要先定:用哪个指标验收、要不要允许"不放大"。数据:5.2、5.3、5.4
对外发布的口径怎么统一
上一版对外报告的 PSNR/SSIM 口径与本版不同,且有若干结论需要更正(第九节);由页面托管方决定是否发布勘误或替换页面。数据:9
复现、来源、许可证、局限
页面本身离线可用;所有素材在 report_assets/,不引用外网字体或 JS。
复现入口
页面数据来自 4090 上的只读文件,下面命令可以逐项核对:
ssh 4090
cat ~/week1/week1_report.md
cat ~/week2/vae_opt3/exp_gn/results/summary.json
cat ~/week2/lora_candidates/tasks/RESULT.json
python3 ~/week2/aigc_eval/runq/status.py
cat ~/week2/aigc_eval/data/scores/S768_*.json
本轮的 H3 多指标(文字侧从 OCR 缓存重算,画质侧逐帧算):
cd ~/week2/aigc_eval
~/week1/eval_v2/venv/bin/python tools/aigc_text_metrics.py
~/exp_seedvr_accel/e2/venv/bin/python tools/aigc_image_metrics.py --every 8 --workers 8
H3 矩阵的评分可自己重跑(纯 CPU,不占 GPU):
cd ~/week2/aigc_eval
/home/ubuntu/week1/eval_v2/venv/bin/python tools/score_pseudo.py \
  --outdir outputs/S768/fastvr --setting S768 --method fastvr --every 4 --workers 12
本地预览(避免 file:// 下视频受限):
cd /Users/user/Documents/默认项目
python3 -m http.server 8000
# 打开 http://localhost:8000/4090_任务汇总.html
数据与素材来源
~/week1/week1_report.md— 14 方法 × 94 条评测 v2 主表、GT 上限、成本。~/week2/vae_opt3/exp_gn/results/summary.json— 112.10 s vs 101.43 s,bit-exact 证据。~/week2/lora_candidates/tasks/RESULT.json— 公开 LoRA 尽调与自训探针。~/week2/aigc_eval/data/manifest.json— H3 矩阵 3 设置 × 7 模型 × 40 条。~/week2/aigc_eval/data/scores/*.json— H3 矩阵的文字评分(本次现跑,逐 clip 明细在 per_clip 里)。~/week2/vae_opt2/profile_gpu/results/— 4090 实测峰值(GEMM 164.2 TFLOPS、拷贝 916.8 GB/s)与 conv roofline(decode 三个主 conv 的 TFLOPS、占峰值)。~/exp_seedvr_accel/e4_profile/reports/— nsys trace 与逐算子/阶段归因(base / gnsilu / l2gncfcl 三份)。~/week2/vae_opt2/ncu/micro_full.ncu-rep— ncu 计数器(root 跑的 micro 探针:tensor pipe 48.8%、DRAM 11.9%、L2 命中 96.7%)。~/week2/visual_report/tools/grid.py+crop_best.py— 16 个案例对比图的生成脚本(按方法几何映射裁切框、最近邻放大、烧方法名)。~/week2/visual_report/cases.json— 16 个 case 的定义与 evidence。~/week2/datasets_pricing_report.md— 竞品价格、数据集与许可。~/next_steps_plan.md— H3 A/B、成本档位、加速与 LoRA 规划。
许可证与合规
- numz 加速仓库:Apache-2.0;代码里没有 LoRA 加载逻辑,接入需离线合并权重或自行注入。
- Lada LoRA:AGPL-3.0,不适合直接进闭源产品;文字指标中性到更差。
- CTVid-Bench:研究用途;逐帧标注与评测协议按原仓库执行。
- MediaKit:价格 ¥0.10/条为 API 报价,尚未核实,不进入成本结论。
- H3:商用条款与配额需账户确认;本页不包含任何 H3 生成素材。
- bicubic:双三次插值(非 AI)基线,用 4×4 邻域加权算出新像素;本报告的对照基准,衡量"AI 超分做文字到底比简单插值强多少"。它出奇难打:文字 Acc 0.669,廉价 AI(FlashVSR+ Turbo 0.581)反而更低;故廉价路 / 文字片段建议回退到它。详见 2、3.1、4.2、6。
局限与不要过度解读
- 所有结果来自单卡 4090、4 秒 / 120 帧 / 1080p;更长视频要分段,numz 的整段窗口优势可能缩小。
- 文字指标是 PaddleOCR 3.3 在 CPU 上跑的;GT Acc 0.832 是平均意义上的上限,不是逐条上限。
- |ΔAcc| < 0.02 落在编码噪声内;7B 的 +0.001 不构成质量优势。
- 101.4 s 是单条单次实验,未做 94 条 A/B;默认仍是 159.1 s 的 numz_wavelet。
- 16 个案例的对比图已全部补齐;生成脚本在
~/week2/visual_report/tools/(grid.py + crop_best.py)。 - H3 矩阵里 numz 3B 的三组已全部跑满(各 40 条),第五节的文字表已是全矩阵;numz 7B 与官方 3B 各只跑了约 20 条,表里已标注。
- MiniMax 官方 H3 API 没有任何实测指标(本机缺 key);第五节的 H3 数字全部来自 H3 生成的素材被各超分模型处理后的评测。
- “小字召回 18%”是 2026-10-16 的 RapidOCR 旧口径,不与本页 Acc 混用。
指标口径速查
- Acc:GT 框裁剪后 OCR,归一化(NFKC、小写、只保留字母/数字/汉字)完全相等的比例;先视频内平均,再 94 条平均。
- NED:1 − 归一化编辑距离,相似度口径,越高越好。
- 翻转率:同一 GT 框在相邻采样帧读数不同的比例,越低越稳。
- Acc_rd:只统计 GT 原片能读出的实例,排除标注/OCR 噪声。
- 成本:单卡墙钟 × ¥4/卡时;主表同时给均值与 p10,p10 近似无争用耗时。
一句话结论
数据支持的读数:numz_wavelet Acc 0.791 / ¥0.044秒,官方 7B 0.792 / ¥0.229秒,二者文字在噪声内;官方 3B 0.747 / ¥0.196秒;FlashVSR+ Turbo 0.581 / ¥0.011秒;bicubic 0.669 / ≈¥0。
能加速的:链路已到 101.4 s(7.0×),但还差 94 条 A/B;补完再切默认。
还没解决的:公开 LoRA 全灭,自研 rank-16 未开训;H3 官方 API 无 key;101.4 s 加速链路未做 94 条 A/B;H3 矩阵 numz 7B 与官方 3B 各只跑了约 20 条。